Почему одной метки «опасно / безопасно» недостаточно
Один и тот же запрос может одновременно относиться к нескольким категориям — например, содержать признаки и финансового мошенничества, и киберпреступления. Поэтому задача поставлена как multi-label: модель принимает 15 независимых бинарных решений на каждый текст, а не выбирает одну категорию из списка.
Это нужно для управляемой модерации: Child_exploitation требуется эскалировать на ручную проверку, а Swear_words достаточно залогировать. Бинарный вердикт такого различия не даёт.
Сами 15 выходов неоднородны, и мы разделяем их явно:
- 11 категорий вреда — эксплуатация детей, насильственные действия, вооружение, наркотики, причинение вреда себе, дискриминация и язык ненависти, нацизм, ненасильственные и финансовые преступления, киберпреступления, порнографические материалы.
- 4 тематических флага — мат, политика, религиозные преступления, ЛГБТ. По умолчанию выключены и включаются под конкретное внедрение.
Правильное прочтение срабатываний — повод показать текст человеку, а не вывод о нарушении. Сама модель ничего не блокирует: она отдаёт вероятности, а действие выбирает вызывающая система.
Как устроена модель
Один forward-проход из четырёх стадий:
- Многоязычный энкодер
mmBERT-base(307M параметров) превращает текст в скрытые состояния. Лимит контекста — 1024 токена. - 15 категориальных экспертов читают состояния параллельно, каждый со своими обучаемыми query-токенами. Эксперты независимы, поэтому редкая категория не делит решение с частой. Единый батчевый forward вместо цикла по категориям даёт ускорение примерно втрое.
- Модуль взаимодействия категорий — двухслойный трансформер, читающий все 15 представлений вместе. Он кодирует то, что метки сообщают друг о друге: контент про оружие обычно и про насилие, нацизм обычно и про дискриминацию.
- Суммирование и сигмоида дают 15 независимых вероятностей, каждая со своим порогом.
При обучении используется асимметричная функция потерь (ASL), намеренно штрафующая пропуски сильнее ложных срабатываний, дифференцированный learning rate (backbone 3e-5, эксперты 5e-4) и EMA-усреднение весов. Пороги подбираются для каждой категории отдельно через grid search, лежат в диапазоне 0.49–0.62 и хранятся отдельно от весов — чувствительность корректируется в production без переобучения.
Лимит в 1024 токена обоснован реальным распределением длин обучающего корпуса:
| Перцентиль | P50 | P75 | P90 | P95 | P99 | P99.5 |
|---|---|---|---|---|---|---|
| Токены | ~43 | ~87 | ~184 | ~279 | ~555 | ~714 |
Половина текстов короче 43 токенов, но хвост растёт нелинейно. При max_length=1024 покрывается 99.78% датасета из 1 836 335 примеров; оставшиеся 0.22% длиннее лимита и все безопасные, поэтому они исключаются из обучения целиком, а не усекаются.
Сравнение с 9 открытыми решениями
Мы прогнали единый бенчмарк двух наших моделей против 9 открытых guardrail- и toxicity-моделей сторонних разработчиков. Выборка — 7 480 примеров внешнего набора, собранного специально для оценки: он не пересекается со сплитами обучающего корпуса, каждый пример размечен тремя аннотаторами (Fleiss' κ = 0.82), баланс 50/50.
| Модель | Binary F1 | F1-micro (14) | F1-weighted (14) | F1-macro (14) |
|---|---|---|---|---|
| HiveTrace Multilabel (наша) | 0.9588 | 0.7403 | 0.7987 | 0.7026 |
| YuFengXGuard_0.6B | 0.9544 | 0.7197 | 0.6625 | 0.4581 |
| Qwen3Guard_8B | 0.9337 | 0.5700 | 0.6683 | 0.3952 |
| Qwen3Guard_4B | 0.9327 | 0.5676 | 0.6678 | 0.3923 |
| Qwen3Guard_0.6B | 0.9235 | 0.5514 | 0.6470 | 0.3746 |
| gliner_guard_omni (наша) | 0.9076 | 0.7111 | 0.7006 | 0.5489 |
| opir_multitask_multilang | 0.8718 | 0.2824 | 0.2564 | 0.2735 |
| gliguard_300m | 0.8025 | 0.5563 | 0.5268 | 0.2395 |
| apanc_russian_sensitive_topics | 0.7295 | 0.4792 | 0.4997 | 0.4149 |
| rubert_tiny_toxicity | 0.5455 | 0.5254 | 0.4114 | 0.1270 |
| unitary_multilingual_toxic | 0.1304 | 0.5183 | 0.3584 | 0.0927 |
Главный вывод: бинарной метрики недостаточно для выбора модели. У Qwen3Guard_8B binary F1 = 0.9337, но multilabel F1-macro всего 0.3952 — модель хорошо ловит «опасно / безопасно» и плохо определяет, чем именно опасно.
По binary F1 наша модель идёт вровень с ближайшим конкурентом: 0.9588 против 0.9544. Разрыв 0.0044 при n = 7 480 укладывается в выборочную погрешность, поэтому честная формулировка — «на уровне», а не «обходим». А разрыв по F1-macro (0.7026 против 0.4581) — другого порядка и распределён по всем категориям.
Отличается и характер ошибок. Семейство Qwen3Guard работает почти исключительно на precision (0.9997 при recall 0.876) — оно не поднимает ложных тревог и платит за это пропусками. Наша модель держит precision 0.9725 при recall 0.9455 — тот баланс, ради которого настраивалась асимметричная функция потерь.
Экономика инференса
Замеры сделаны на одной NVIDIA RTX 3090 для трёх бэкендов при фиксированных размерах батча.
| Batch | PyTorch P95 | TensorRT P95 | TensorRT, текстов/с | PyTorch, $/1M | TensorRT, $/1M |
|---|---|---|---|---|---|
| 1 | 17.4 мс | 5.9 мс | 173.4 | 1.3528 | 0.4806 |
| 8 | 18.2 мс | 7.9 мс | 1045.1 | 0.1788 | 0.0797 |
| 16 | 18.8 мс | 12.5 мс | 1345.1 | 0.0944 | 0.0620 |
| 64 | 72.4 мс | 69.1 мс | 954.6 | 0.0909 | 0.0873 |
Оптимум — TensorRT при batch=16: лучшая задержка среди практичных размеров батча, наивысшая пропускная способность и наименьшая стоимость одновременно, компромисса между ними здесь нет. Это в 2.9 раза дешевле наивного фиксированного batch=8 на PyTorch и в 21.8 раза дешевле работы вообще без батчинга. При batch ≥ 32 бэкенды сходятся и преимущество TensorRT практически исчезает. Веса модели ни одна из этих оптимизаций не затрагивает.
Для сравнения: внешний LLM-as-judge через API — это 300–2000 мс задержки и $63–400 за миллион запросов. Собственная модель выигрывает у него на 1–2 порядка по латентности и на 3–4 порядка по стоимости, а данные при этом не покидают инфраструктуру компании.
Где система ошибается
Агрегаты скрывают неровный профиль, поэтому называем слабые места прямо. Шесть из 13 risk-категорий бенчмарка попадают в диапазон 0.73–0.96 (Drugs 0.90, LGBT 0.89, Swear_words 0.86, Self_harm 0.85, Sexual_content 0.82, Child_exploitation 0.73), остальные ниже: Weapons 0.68, Religion 0.62, Politics 0.58, Cybercrime 0.56, Hate_discrimination 0.56, Violence 0.48, Non_violent_crime 0.34.
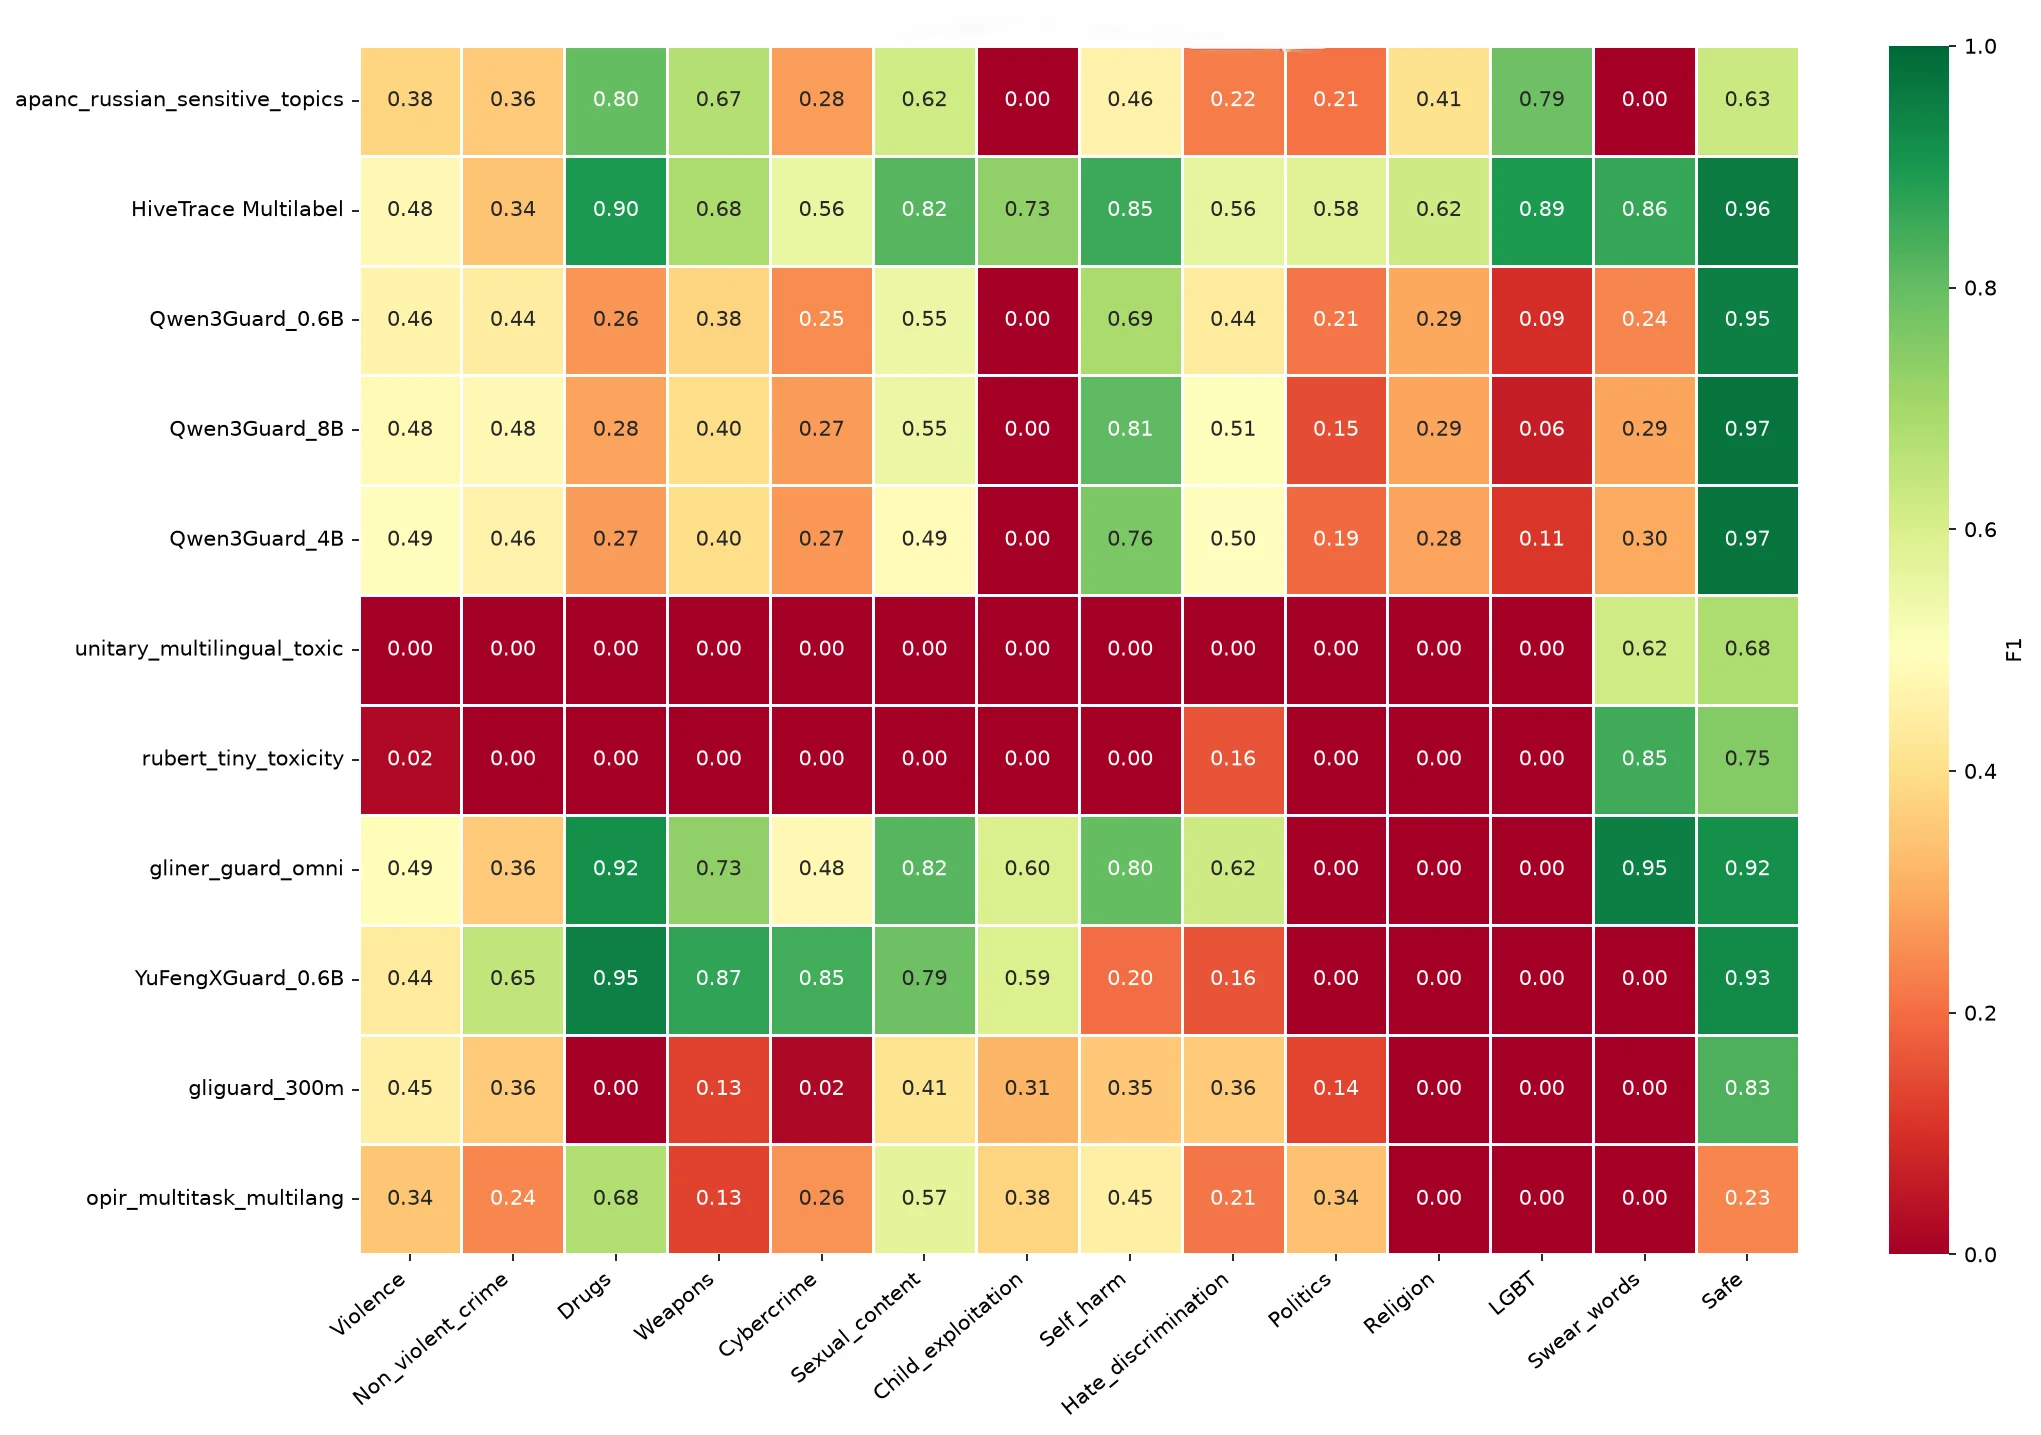
Hate_discrimination с F1 0.56 — критичная категория, которой нужен отдельный дашборд recall, а не вера в агрегат. Non_violent_crime с F1 0.34 — объединённая категория бенчмарка, вобравшая финансовые преступления, поэтому часть слабости объясняется свёрткой. Если убрать производную метку Safe, macro-F1 только по 13 risk-категориям — 0.682 против 0.7026 по 14 меткам.
Есть и системные ограничения:
- принципиально новые техники обфускации потребуют дообучения — модель устойчива к трансформациям из обучающей выборки;
- окна длинных запросов скорятся без контекста остального документа;
- совместное срабатывание 4+ категорий в обучающих данных встречалось редко, и поведение модели здесь менее предсказуемо.
Подстраховка одна и та же во всех случаях: пороги правятся в production мгновенно, а для критичных для вас категорий, рекомендуется human-in-the-loop эскалация в «серой зоне».
Guardrail-классификатор закрывает регуляторный и репутационный риск на объёмах, где ручная модерация уже не масштабируется, и оставляет данные внутри контура компании.
Полная методология бенчмарка, детали архитектуры и метрики доступны в техническом отчёте.